나무에스디
2024.09 — 현재매니저 · 웹 시스템 개발·운영
- 고객사 보안포털 개발·운영기능 개선과 메뉴 추가, 권한·조직 연동을 담당하며 운영 이슈에 대응했습니다.
- AI 영상 얼굴 식별 솔루션 개발Python 분석 파이프라인과 Spring 백엔드, Vue 편집 기능을 개발하고 연결했습니다.
백엔드 개발자
Kim Dongwoo
고객사 업무 시스템을 개발·운영하고,
영상 얼굴 식별 솔루션을 고도화했습니다.업무 흐름을 API와 화면으로 구현하고,
운영 과정에서 발견한 문제를 개선합니다.
매니저 · 웹 시스템 개발·운영
 Spring Boot
 Vue 2Vue 3
 MySQL
 MariaDB
좌우로 이동하거나 크게 보기로 전체 그림을 확인하세요.
정면 사진 한 장은 영상 속 다양한 각도와 표정을 충분히 대표하지 못했습니다. 여러 참조 이미지에서 품질과 일관성을 확인하고, 각도별 대표 임베딩을 구성해 비교 기준을 보완했습니다.
참조를 늘리는 것뿐 아니라 어떤 얼굴을 비교 기준으로 삼을지가 중요했습니다.
좌우로 이동하거나 크게 보기로 전체 그림을 확인하세요.
자동 클러스터링에서 같은 사람이 나뉘거나 다른 사람이 섞이는 오류를 사용자가 바로잡도록 검수 단계를 추가했습니다. 보정한 인물 세트로 참조 기준을 다시 구성하고, 기존 임베딩을 재사용해 식별 결과에 반영했습니다.
화면에서 수정한 결과가 다음 편집에도 이어지도록 얼굴·군집·인물 세트의 연결 기준을 맞췄습니다.
산업경영공학과 · 학사
MEMBERSHIP SERVICE
자양동 맥주집을 위한 고객·매장 멤버십.
도장 적립과 쿠폰 이용, 회원 관리를 하나의 서비스로 연결합니다.
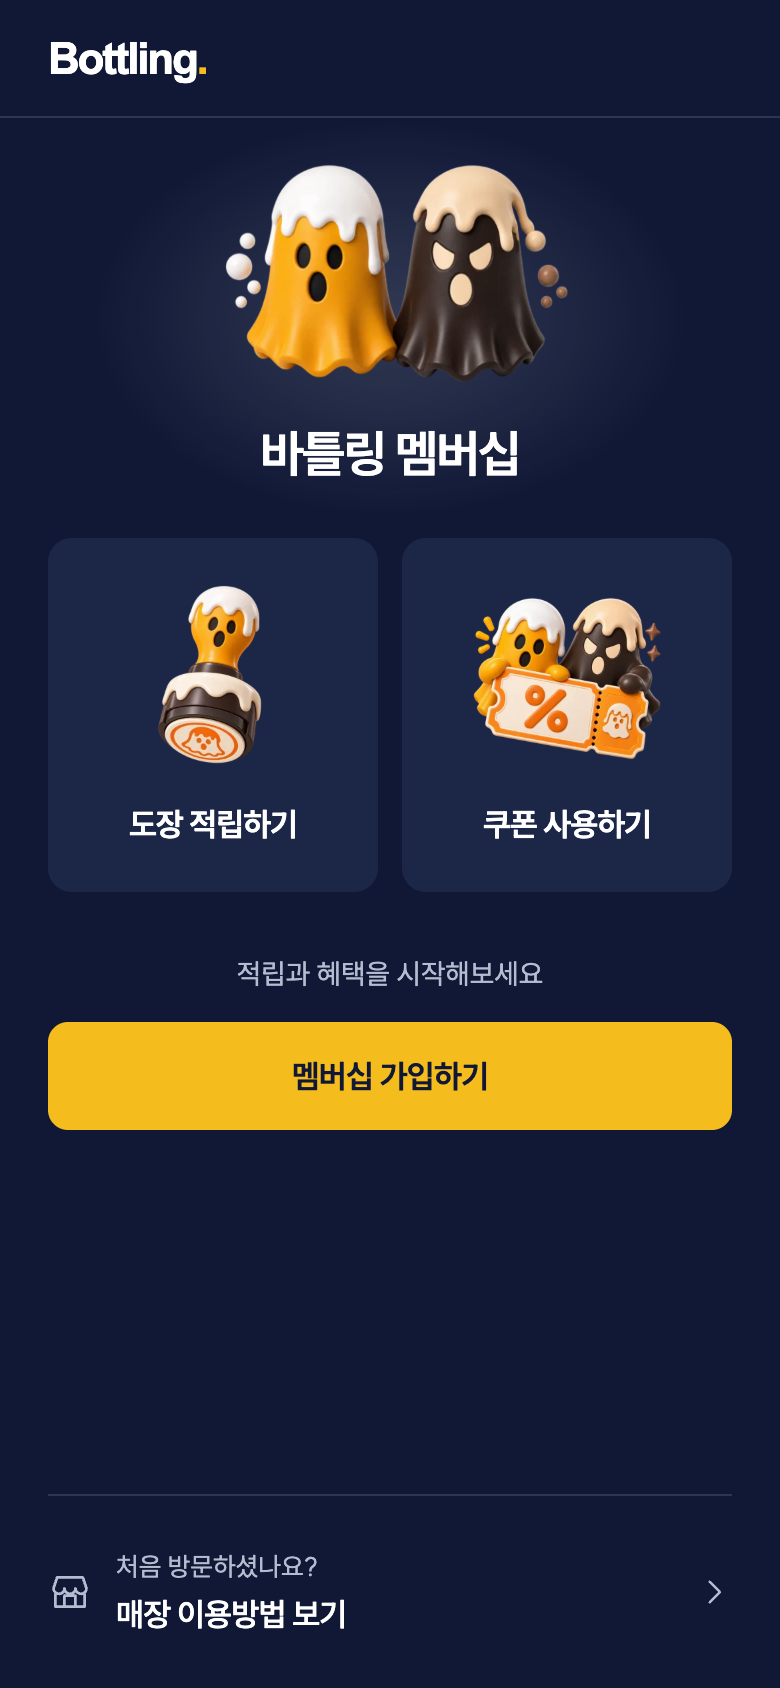
01로그인 전 메인
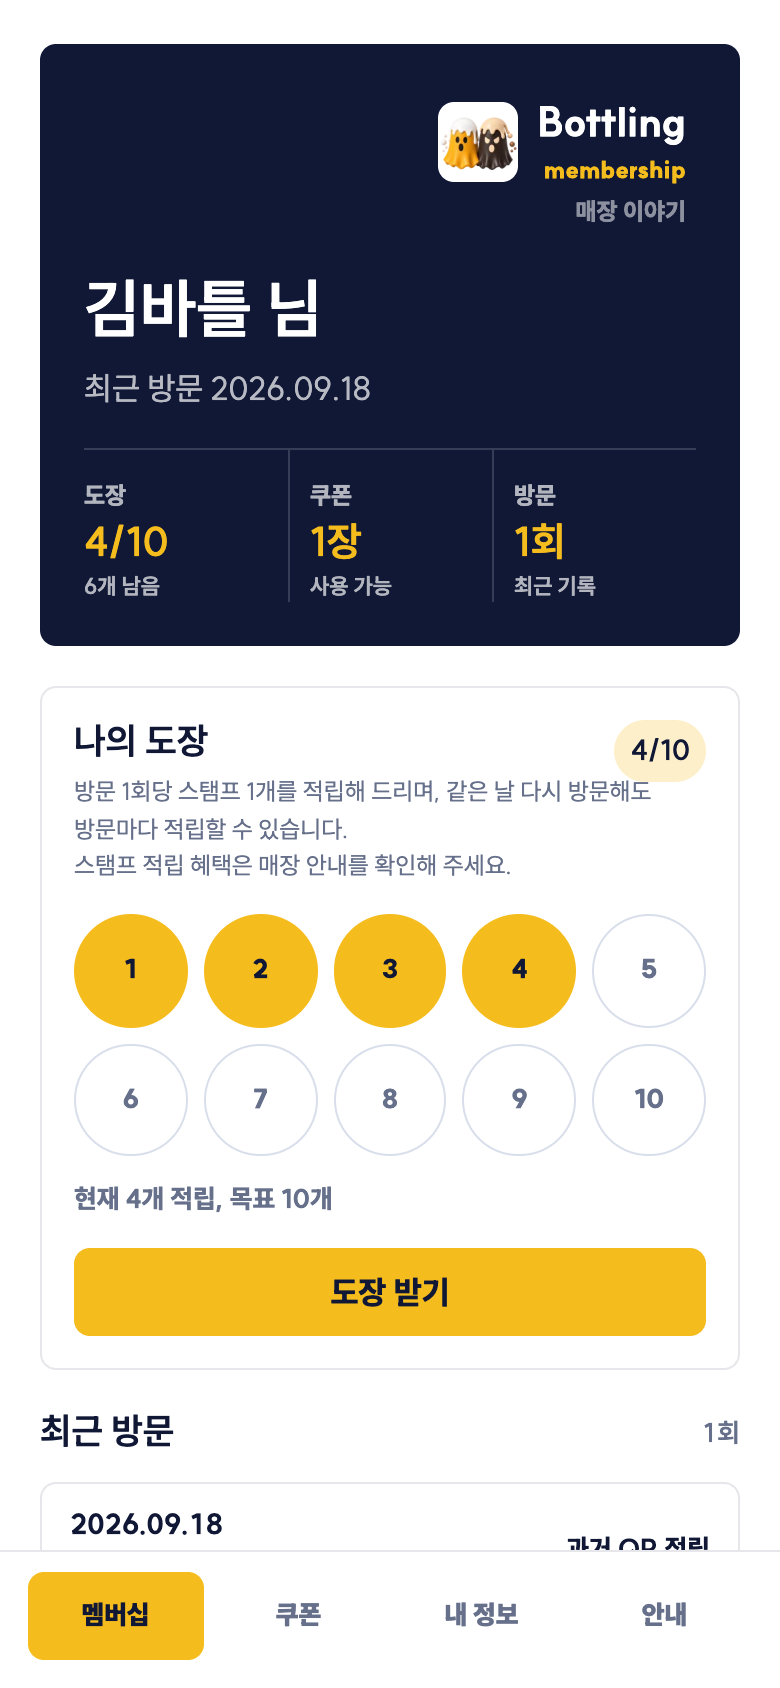
02로그인 후 메인
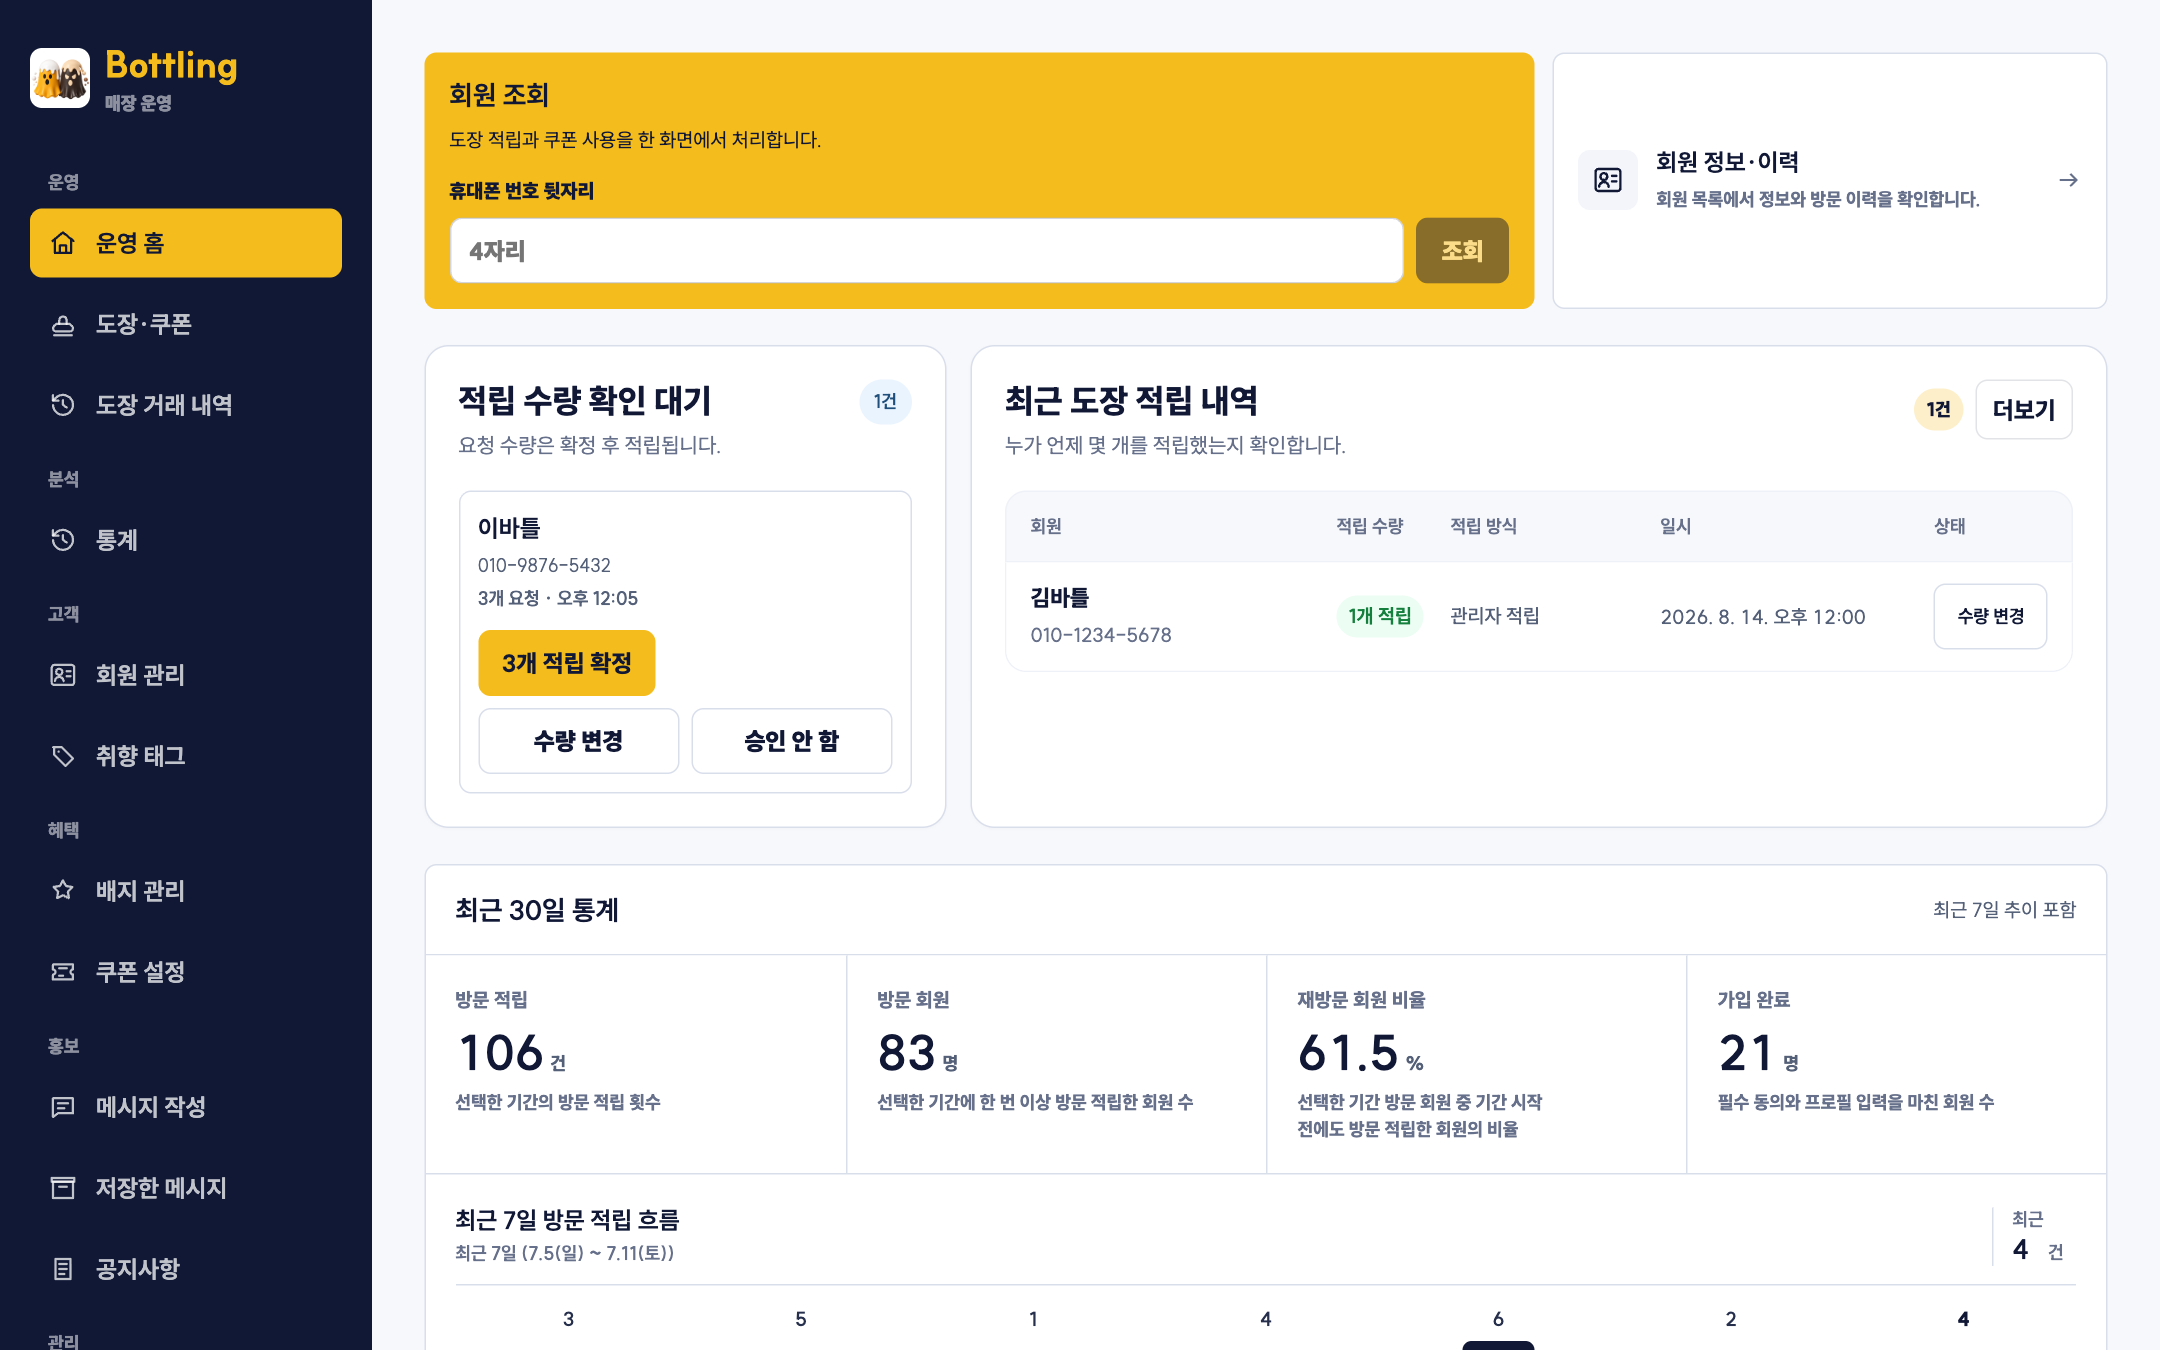
03관리자 메인 · PC
로그인 전 메인 · 고객 멤버십 · 관리자 PC 운영 홈 — 고객·관리자 메인은 샘플 데이터 화면입니다.
Bottling은 단일 매장의 고객 멤버십과 직원 운영을 연결하는 서비스입니다. 고객은 카카오 로그인으로 가입하고 도장·쿠폰을 사용하며, 관리자는 회원·보상·공지·NFC 장치를 운영합니다.
고객·관리자 화면을 하나의 Vue SPA로 제공하고, Hono Worker가 인증과 업무 규칙을 처리합니다. 데이터는 D1에 저장하며 NFC 물리 작업은 관리자 PC의 CLI에서 수행합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
브라우저, Worker, D1, NFC 운영 도구의 책임과 공통 응답 구조를 설명합니다.
Vue 3 / Vite / TypeScript / Pinia → Hono Cloudflare Worker
Worker 도메인 모듈 → Cloudflare D1 / 공통 HTTP 응답 경계
{ data: payload }{ error: { code, message, status } }관리자 PC의 NFC CLI → PC/SC 리더 / 인증된 Worker API
카카오 로그인에서 회원 상태·동의·프로필 확인을 거쳐 멤버십으로 연결합니다. 고객과 관리자 인증은 principal과 접근 정책을 분리합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
OAuth 검증, 토큰 회전, 고객 화면의 분기 조건을 단계별로 설명합니다.
Vue 고객 화면 → Worker OAuth route → Kakao / D1
Worker 인증 모듈 → D1 세션·권한 정보
고객 store → router guard → consent / profile / complete
적립 결과는 방문·도장 원장·카드·쿠폰·감사 이력으로 연결됩니다. 동일 작업 재요청은 receipt로 판별하고, 새 작업의 관련 기록은 D1 batch에서 함께 확정합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
operation admission, D1 batch, 쿠폰 상태와 운영 보정 규칙을 설명합니다.
관리자 / NFC 적립 명령 → Worker admission / runtime guard
operationId · requestSha256awardStamps → D1 visit / issue group / ledger / card / coupon / audit
고객 / 직원 coupon API → Worker coupon domain → D1
관리자 보정 / recovery / badge rule → Worker
고객 intent와 태그가 생성한 동적 proof를 Worker에서 검증합니다. 도장 1개는 바로 적립하고, 여러 개는 관리자 확인을 거쳐 확정합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
intent, fragment, 암호학적 검증, 단일/다중 적립과 상태 복원을 설명합니다.
고객 NFC store → Worker intent API / Vue fragment parser
stampCount · 고객 인증Worker consume → NTAG424 proof verifier → D1 device / keyset
Worker proof event / stamp award → 관리자 confirm 또는 reject
Worker 결과 snapshot → customer NFC store → 상태 화면
등록 파일 준비, 태그 개인화, 서버 검증, 서비스 활성화를 구분합니다. 두 번의 proof와 counter 증가를 확인한 뒤 OWNER가 장치를 활성화합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
파일·리더·서버 상태의 경계를 나눠 물리 작업과 활성화 조건을 설명합니다.
관리자 PC NFC CLI → 관리자의 Worker provision
bottling-nfc CLI → PC/SC reader → NTAG424
nfc-validation-proof.json관리자 proof 제출 → Worker 검증 → OWNER activate
권한 검증과 operationId를 공통 적용하고, 서버에서 확정한 작업 결과를 재조회합니다. 작업 성공 이후 조회 실패는 경고로 보여줘 중복 실행을 방지합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
관리자 역할, 세션 갱신, 확정 작업 표시와 CLI의 불명확 결과 조정을 설명합니다.
관리자 별도 로그인 → Worker role / D1 principal 검증
관리자 Pinia store → requestAdminWithRefresh → Worker
admin stamp store / NFC CLI → 조회를 통한 결과 확인
Worker·Frontend·NFC CLI 검증을 거쳐 동일 build SHA를 확인하는 배포 흐름입니다. 운영 변경은 전환 확인을 거치며, 보존 처리는 목적별 scheduled job으로 분리합니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
환경별 실행 대상, 전환 검증, 일반 보존과 탈퇴 정리의 입출력을 설명합니다.
저장소 check/test/build 절차 → GitHub Actions / Wrangler
운영자 전환 요청 → Worker runtime_controls / transition receipt
Cloudflare Cron → Worker scheduled → D1 retention batch
VIDEO DE-IDENTIFICATION
영상 속 얼굴을 검출하고, 임베딩으로 인물을 식별하는 솔루션.
사용자가 분석 결과를 검수하고 프레임별로 편집할 수 있도록 구현했습니다.
99duuk Blur 샘플 편집 화면
Python 영상 분석 파이프라인과 Spring 백엔드, Vue 편집 화면을 연결한 프로젝트입니다. 공개 샘플에서 캔버스 편집과 인물 세트, 결과 확인 화면을 살펴볼 수 있습니다.
Vue 편집 화면과 Spring 업무 API, Kafka로 연결된 Python 분석 엔진. 영상과 분석 파일은 MinIO에서 공유합니다.
등록 직후 타임라인 생성과 얼굴 분석을 각각 요청합니다. 두 작업이 모두 성공하면 편집 준비가 완료됩니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
등록 요청, 병렬 작업, 상태 합성, 화면 분기를 단계별로 설명합니다.
Vue 등록 화면 → Spring 등록 coordinator → DB / MinIO
workTitle · fileimages[인물키]original.<ext>target_image/<인물키>/…Spring dispatcher → Kafka → Python consumer / worker
video_id · bucket · 원본 URLvideo-timeline-requestsvideo-processing[-light]-requestsmetadata.json · 분석 산출물Spring 응답 handler → Video 상태 / 파일 정보 → SSE
timelineStatus / processingStatusvideoStatus · 파일 정보video-status-changedVue 라우팅 판단 → 인물 그룹 / 편집 / 결과 화면
videoStatus · isLightisTargetManualhasSuggestClusterSets정밀 분석은 얼굴 임베딩으로 참조 인물을 매칭하고 검수용 얼굴을 추천합니다. 경량 분석은 검출·추적을 중심으로 프레임별 얼굴 정보를 만듭니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
사용 모델은 기본 설정과 지원 모델을, 처리 방식은 수행 순서를, 입출력은 단계 사이에 전달되는 파일과 필드를 정리했습니다.
original.mp4로 등록하고 해상도·프레임 수·FPS·변환 정보를 기록합니다.original.mp4original.mp4yolov8n-face-derronqi.ptYOLO · 가중치 경로 설정 가능frame_stride 간격으로 프레임을 선택하고 배치로 추론합니다.6DRepNet_300W_LP_AFLW2000.pthq.aligniresnet50-7f187506.pth0~1 또는 -1~1)를 적용합니다.embeddings.npy에 저장하고, 각 얼굴에 해당 행의 embedding_idx를 연결합니다.embeddings.npyembedding_idxq.embedsugg_targembeddings.npy를 재사용합니다. 이 경로에서는 그룹 공백 보완과 비대상 얼굴 추적을 추가로 수행합니다.embeddings.npy · metadata.jsonset_id · cluster_idsis_targettarget_group_idcluster_id를 부여합니다.cluster_idsuggest_cluster/…track_id를 부여하고 짧은 track 처리 정책을 적용해 편집용 프레임 metadata를 구성합니다.track_idmetadata.jsonvideo_id · bucket · 객체 경로 · 작업 옵션자동으로 제안된 얼굴 묶음을 사용자가 같은 인물의 세트로 정리합니다. 검수 결과는 기존 임베딩을 재사용하는 재판정의 입력이 됩니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
사용자 그룹 데이터가 서버 저장과 Python 재판정으로 이어지는 계약을 설명합니다.
Python 추천 산출물 → Vue 그룹 검수 화면
cluster_idVue payload helper → Spring SuggestClusterSetService
sets: setId · clusterIdsunassignedClusterIds · promotedClusterIdsembeddingRemaps: embeddingIdx · clusterIdSpring Reference client → Kafka → Python 그룹 재판정
video_id · bucket · cluster_prefixsets: set_id · cluster_idsis_target · target_group_idnon_target_track_id · 판정 통계Spring 응답 대기·상태 처리 → Vue 편집 화면
metadata.jsonapply_blur브라우저에서 보정한 좌표와 모자이크 적용 여부가 metadata.json을 거쳐 최종 영상에 반영됩니다.
좌우로 이동해서 전체 흐름을 볼 수 있습니다.
apply_blur를 저장합니다. Python은 현재 작업 파일을 읽어 실제 영상 픽셀을 처리합니다.프레임 편집 상태를 확정하고 실제 영상 파일로 생성하는 과정을 설명합니다.
Vue 파일 로드 / 좌표 변환 → Pinia mosaic-store
original.mp4 · metadata.jsontimeline.json · 프레임별 x1/y1/x2/y2Record<frame, Rect[]>apply_blurCanvas 입력 / 플레이어 → 임시 도구 상태 → 프레임 Rect
apply_blurVue 저장 API → Spring 편집 orchestrator → MinIO / Kafka
videoIdmetadata.jsonvideo_id · bucket · phasePython finalize → 프레임별 모자이크 → H.264 인코딩
original.mp4 + metadata.jsonapply_blur · phasefinal.mp4 / final_rework.mp4Spring 응답 handler → DB / SSE → Vue 결과 화면
원본 영상 위에 Canvas를 겹쳐 얼굴 영역을 표시합니다. Pinia가 프레임별 Rect를 보관하고, 고정·범위·추적 도구의 편집 결과를 저장 전 프레임 데이터에 반영합니다.
다중 참조를 통한 인물 판정과 사용자 검수 결과를 재판정에 연결한 과정을 정리했습니다.
인물별 참조 이미지를 여러 장으로 확장하고, 샘플의 품질·일관성·촬영 각도를 고려해 비교에 사용할 대표 임베딩을 구성했습니다.
좌우로 이동하거나 크게 보기로 전체 그림을 확인하세요.
얼굴 검출과 인물 식별은 서로 다른 문제입니다. 검출은 영상에서 얼굴의 위치를 찾는 일이고, 식별은 그 얼굴이 등록한 참조 인물과 같은 사람인지 판단하는 일입니다. 얼굴 박스를 잘 찾았더라도 식별 결과가 항상 맞는 것은 아닙니다.
기존 경험 기록에는 얼굴 크기·각도·가림 등 촬영 조건에 따라 같은 인물의 판정이 달라지는 사례를 비교한 내용이 있습니다. 특히 참조 이미지 한 장에만 의존하면 그 사진의 흐림, 정렬 상태, 촬영 방향이 해당 인물을 대표하는 기준 전체에 영향을 줍니다.
이 문제를 다루면서 참조를 ‘정답 사진 한 장’이 아니라 서로 다른 품질과 촬영 조건을 가진 샘플 집합으로 보기 시작했습니다. 인물별 여러 이미지를 입력받고, 어떤 샘플을 사용할지와 어떻게 합칠지를 참조 처리의 책임으로 나눴습니다.
영상에서 검출한 얼굴과 참조 이미지 모두 얼굴 검출·정렬·임베딩 추출이라는 공통 경로를 거칩니다.
현재 코드는 ArcFace와 FaceNet 계열의 실행 경로를 지원합니다. 참조와 영상 얼굴은 같은 embedding backend를 기준으로 비교해야 하며, 두 모델의 점수 분포나 임계값을 같다고 가정하지 않습니다.
이 기록의 범위는 기존 모델을 연결하는 파이프라인과 참조 판정 정책입니다. 얼굴 인식 모델을 새로 학습하거나 독자 모델을 개발한 성과로 설명하지 않습니다.
참조 이미지 수를 늘려도 잘못 검출된 얼굴, 심하게 흐린 이미지, 정렬이 어긋난 샘플이 함께 들어오면 대표 벡터의 기준이 흔들릴 수 있습니다. 입력 수 증가와 참조 품질 관리는 별도로 다뤄야 합니다.
기존 기여 기록에는 낮은 품질의 참조 제외, robust mean 적용, 참조 일관성 보완이 단계적으로 추가된 흐름이 있습니다. 현재 구현에서도 얼굴 크기와 검출·정렬 정보를 다루고, 사용 가능한 참조 임베딩으로 대표 벡터를 구성합니다.
품질과 일관성은 같은 의미가 아닙니다. 선명한 다른 사람의 얼굴은 시각적 품질은 좋더라도 해당 인물의 참조로는 부적절할 수 있습니다. 반대로 중심 벡터와 유사도가 낮은 사진이 반드시 다른 사람이라고 확정되는 것도 아닙니다. 샘플을 거르는 기준을 실제 신원의 정답으로 취급하지 않도록 구분했습니다.
현재 구현의 robust mean은 중심과의 cosine 유사도가 낮은 샘플의 영향을 줄이는 trimmed mean 방식입니다.
항상 샘플을 잘라내지는 않습니다. 현재 함수는 샘플이 4개 미만이거나 trim 비율이 0 이하이면 trimming 없이 평균을 사용하고, 설정 비율은 0~49 범위로 제한합니다. 적은 샘플에서 과하게 제외하거나 잘못된 설정으로 대부분의 정보를 없애지 않기 위한 조건입니다.
이 방법의 목적은 일부 비일관적인 샘플이 대표 벡터에 주는 영향을 줄이는 데 있습니다. 다수의 잘못된 참조가 섞여 있거나 표본 자체가 부족한 상황까지 자동으로 해결하는 방식은 아닙니다.
정면과 측면 얼굴을 하나의 평균으로만 압축하면 서로 다른 촬영 조건이 섞입니다. 현재 참조 구성은 인물 ID를 유지하면서 각도 구간별 대표 벡터를 만들고, 비교할 때 각도 구간과 좌우 방향 정보를 함께 사용합니다.
| 단계 | 처리 내용 |
|---|---|
| 참조 구성 | 동일 인물의 샘플을 각도 구간별로 모아 대표 임베딩 구성 |
| 원시 비교 | 영상 얼굴 임베딩과 각 참조 벡터 사이의 cosine 유사도 계산 |
| 조건 보정 | 각도 구간·좌우 조건에 따른 penalty를 반영 |
| 인물별 집계 | 같은 인물에 속한 여러 참조 벡터 중 최대 보정 점수를 선택 |
| 최종 판단 | backend에 맞는 임계값과 판정 정책으로 인물 매칭 여부 결정 |
여러 참조 벡터를 비교하더라도 최종 결과는 인물 단위로 정리합니다. 어떤 각도 구간의 참조가 선택됐다는 사실과, 어느 인물로 판정됐다는 결과를 구분하기 위해서입니다.
원시 cosine 유사도와 조건을 반영한 보정 점수도 구분합니다. 보정된 점수만 보면 임베딩 자체가 비슷했던 것인지, 어떤 비교 조건이 결과에 영향을 줬는지 추적하기 어렵기 때문입니다.
파이프라인에는 얼굴 크기·선명도·조명·가림·각도 등 품질 정보와 추천 후보 점수가 존재합니다. 이들은 사용자가 검수하기 좋은 얼굴을 우선 제시하거나 참조 구성에 필요한 정보를 남기는 데 사용합니다.
하지만 검출 confidence, 추천 점수, cosine 유사도, 실제 식별 정확도는 서로 다른 값입니다. 추천 점수가 높은 얼굴이라고 해서 특정 인물일 확률이 그만큼 높다는 뜻은 아닙니다. 휴리스틱 점수를 정답률처럼 표현하지 않고, 각 값의 생성 목적과 사용 단계를 분리했습니다.
참조 한 장을 기준으로 비교하던 흐름에서 여러 참조의 품질과 일관성을 살피고, 촬영 각도를 고려한 대표 벡터와 인물별 점수로 판단하는 흐름으로 확장했습니다. 잘못된 결과를 볼 때도 검출·정렬·샘플 구성·유사도·각도 조건 중 어느 부분을 살펴볼지 나눌 수 있게 됐습니다.
다만 가림이 심하거나 얼굴 정보가 부족한 장면, 참조 자체가 부적절한 경우의 판단에는 한계가 남습니다. 이 때문에 자동 판정 뒤에 사용자가 얼굴 묶음을 검수하고 다시 반영할 수 있는 경로를 연결했습니다.
정확도 개선을 수치로 말하려면 동일한 영상·정답 데이터·모델·임계값·처리 설정으로 전후 비교해야 합니다. 현재 원고에는 그러한 비교 결과가 없으므로 정확도 향상률을 적지 않습니다.
인물 식별을 개선할 때 임계값 하나만으로 판단하기보다 비교 기준이 되는 참조가 어떻게 만들어졌는지부터 살펴볼 필요가 있었습니다. 입력 품질, 대표 벡터 구성, 비교 조건을 나눠야 어느 조정이 어떤 결과를 만들었는지 설명할 수 있습니다.
자동 얼굴 군집을 사용자가 인물 단위로 정리하고, 그 결과를 기존 임베딩을 사용하는 재판정 입력으로 연결했습니다.
좌우로 이동하거나 크게 보기로 전체 그림을 확인하세요.
자동으로 묶은 얼굴은 실제 인물과 항상 일치하지 않습니다. 같은 사람이 각도나 품질 차이 때문에 여러 군집으로 나뉠 수 있고, 서로 다른 사람이 같은 군집에 섞일 수도 있습니다. 어느 군집에도 충분히 매칭되지 않은 얼굴이 검수 대상이 될 수도 있습니다.
이때 화면에서 그룹 이름이나 배치만 바꾸고 분석 데이터가 그대로라면, 사용자가 내린 판단이 다음 편집이나 영상 처리에 이어지지 않습니다. 검수 UI의 결과를 저장하는 것과 영상 전체의 인물 판정에 반영하는 것을 하나의 흐름으로 연결할 필요가 있었습니다.
기여 이력에는 타깃 후보 추천, 노이즈 얼굴 remap, 클러스터 승격, 그룹 세트 저장과 재판정 응답 대기가 이어서 추가된 기록이 있습니다. 자동 결과를 확인하는 화면에서, 사용자의 판단을 다시 분석에 사용할 수 있는 구조로 확장한 과정입니다.
| 개념 | 의미 | 사용자가 할 수 있는 작업 |
|---|---|---|
cluster | 자동으로 제안된 얼굴 묶음 | 같은 인물의 다른 군집과 함께 배정 |
set | 사용자가 같은 인물이라고 정리한 군집 집합 | 여러 cluster를 한 인물 세트로 구성·해제 |
unassigned | 인물 세트에 배정하지 않은 군집 | 배정하거나 미배정 상태로 유지 |
unmatched | 자동 클러스터링 결과에 충분히 매칭되지 않은 얼굴 | 검수 후 일부 얼굴 선택 |
promoted cluster | 선택한 미매칭 얼굴에서 만든 새 군집 | 인물 세트에 포함 |
embedding remap | 개별 얼굴의 군집 소속 변경 | 잘못 섞인 얼굴만 다른 군집으로 이동 |
군집 전체를 이동하는 작업과 얼굴 한 개의 잘못된 배정을 수정하는 작업을 구분했습니다. 사용자 입장에서는 모두 ‘인물 정리’이지만, 서버가 갱신해야 할 데이터 범위가 다르기 때문입니다.
정밀 분석에서 추출한 임베딩은 embeddings.npy에 저장하고, 프레임별 얼굴 정보에는 해당 행을 가리키는 embedding_idx를 남깁니다. 검수 화면의 얼굴 이미지, 자동 클러스터링 결과, 프레임의 얼굴 정보가 같은 샘플을 가리킬 수 있게 하는 연결입니다.
여기서 embedding_idx는 얼굴 샘플의 인덱스이며 전역 인물 ID가 아닙니다. 한 사람이 여러 프레임에 등장하면 여러 얼굴 샘플과 임베딩이 생깁니다. 자동 묶음은 cluster_id, 사용자가 구성한 인물은 set_id, 재판정 결과는 target_group_id로 구분해 해석합니다.
이 구분 덕분에 이미 추출한 임베딩을 유지하면서 얼굴의 군집 소속이나 인물 세트 구성을 수정할 수 있습니다. 사용자가 그룹을 수정할 때마다 영상 전체에서 얼굴을 다시 검출하고 임베딩을 추출하는 경로로 돌아갈 필요가 없도록 한 것입니다.
프론트는 검수 화면의 상태를 다음 항목으로 나눠 Spring에 전달합니다.
sets: 인물 세트 ID와 포함된 cluster ID 목록.unassignedClusterIds: 세트에 배정하지 않은 군집 목록.promotedClusterIds: 미매칭 얼굴에서 승격한 군집 목록.embeddingRemaps: 개별 embedding index의 새 cluster ID.설명용 예로, cluster 2와 3이 같은 사람이라면 같은 set에 넣고, cluster 4는 미배정으로 남길 수 있습니다. 그중 한 얼굴만 다른 사람이라면 해당 embedding_idx의 배정을 별도로 수정합니다. 이 예시의 번호는 실제 사용자 데이터가 아닙니다.
세트의 표시 이름과 저장 식별자도 구분합니다. 현재 서버 계약에서 label은 영구 저장 대상이 아니므로, 화면에 입력한 이름 자체가 이후 분석의 기준이 된다고 설명하지 않습니다. 재판정에서 사용하는 핵심은 세트와 군집의 식별 관계입니다.
검수 결과는 브라우저 상태뿐 아니라 현재 metadata, 추천 얼굴 이미지의 정보, DB 세트 매핑에도 영향을 줍니다. SuggestClusterSetService는 다음 순서로 작업을 조율합니다.
각 구성요소가 서로 다른 편집 파일을 보지 않도록 현재 작업 기준은 metadata.json으로 맞추고, 최초 기준 보존에는 og_metadata.json을 사용합니다. 기존 작업 기록에 있던 ‘프론트가 보는 파일과 Python이 수정하는 파일이 다른 문제’와 연결되는 정합성 기준입니다.
다만 DB와 객체 저장소, Kafka 작업을 하나의 분산 트랜잭션으로 묶는 구현은 아닙니다. 중간 실패 시 어떤 파일과 매핑까지 반영됐는지는 따로 확인할 필요가 있습니다.
그룹 기반 재판정은 최초 참조 이미지 등록과 다른 진입 경로인 run_reference_from_groups로 들어옵니다. 이미 생성한 embeddings.npy와 현재 metadata.json이 필요하며, 두 산출물이 없으면 이 경로를 그대로 실행할 수 없습니다.
여기서 추적 보완은 이미 검출된 얼굴의 판정을 이어주는 처리입니다. 검출하지 못한 얼굴을 항상 복원하거나, 가려진 얼굴의 정확한 위치를 모두 알아낸다는 의미는 아닙니다. 최초 참조 이미지 매칭 경로에도 같은 후처리가 항상 적용된다고 묶어 설명하지 않습니다.
검수 결과를 서버가 받았다는 사실만으로 Python 재판정이 끝난 것은 아닙니다. Spring은 Kafka 요청 전에 videoId를 키로 응답 대기를 등록하고, CompletableFuture로 최대 30초 동안 결과를 기다립니다.
202 경로로 응답합니다.HTTP 202를 최종 성공으로 해석하면 화면은 새 판정을 보여준다고 생각하지만 실제로는 이전 결과를 읽을 수 있습니다. 접수·처리 중·완료를 구분하는 것이 검수 저장과 후속 편집을 연결하는 데 중요합니다.
현재 응답 대기는 서버 프로세스의 메모리에 있습니다. 서버 재시작 후 대기 복구나 여러 인스턴스 사이의 응답 전달까지 지원하는 영속 작업 추적기로 설명하지 않습니다. 같은 영상에 대한 동시 요청을 모두 독립적으로 추적하는 구조도 아닙니다.
재판정은 얼굴이 어느 인물 그룹에 속하는지 갱신합니다. 사용자는 이후 편집기에서 프레임의 얼굴 영역과 적용 여부를 최종 확인하고 수정할 수 있습니다.
is_target은 참조 인물과 매칭됐는지 나타내고, apply_blur는 실제 모자이크 적용 여부를 나타냅니다. 참조로 식별된 인물을 기본적으로 모자이크에서 제외하는 화면 정책이 있더라도, 최종 출력에는 사용자가 확정한 apply_blur를 명시적으로 저장하는 계약이 필요합니다.
검수·재판정·편집은 서로 이어지지만 각 단계가 결정하는 값이 다릅니다. 군집을 합쳤다는 이유만으로 모든 프레임의 최종 출력이 확정된 것으로 취급하지 않도록 구분했습니다.
자동 추천에서 끝나던 결과를 사용자가 인물 단위로 수정하고, 그 판단을 기존 분석 산출물에 다시 반영할 수 있게 연결했습니다. 프론트의 드래그·배정 결과가 metadata 수정과 reference 재판정의 실제 입력이 된다는 점이 핵심입니다.
이 작업에서 중요했던 것은 검수 화면의 조작 수보다 사용자가 수정한 얼굴을 서버와 분석 엔진도 같은 대상으로 해석하는 데이터 계약이었습니다. 임베딩 인덱스, 군집 ID, 인물 세트 ID의 의미와 저장 시점을 구분해야 화면의 수정이 다음 처리에서도 유지됩니다.
기존 임베딩 재사용으로 검출·임베딩 추출을 반복하지 않는 실행 경로를 만들었지만, 전체 검수 시간이나 정확도 개선율을 측정한 자료는 별도로 필요합니다. 이 기록에서는 사용자의 정정이 재판정과 편집으로 이어지는 기능적 변화까지 설명합니다.